Что делать, если название вашего бренда путают поисковики и нейросети
Представьте: потенциальный клиент перед подписанием договора открывает ChatGPT или спрашивает у Алисы: «Можно ли доверять компании АБВ?» И получает уверенный, развёрнутый ответ: «Компания АБВ имеет множество негативных отзывов, клиенты жалуются на невыполнение обязательств, есть упоминания о мошенничестве».
Проблема в том, что речь идет о другой компании с таким же названием, из другого города, из другой отрасли. Но нейросеть об этом не знает. Она «сшила» две сущности в одну и выдала результат с уверенностью эксперта. Клиент не будет разбираться, он просто закроет вкладку и уйдёт к конкуренту.
Это реальный кейс из практики нашего агентства: клиент с узнаваемой трёхбуквенной аббревиатурой в названии, о котором четыре из пяти популярных нейросетей на прямой вопрос о надёжности рассказывали чужие истории про жалобы, долги и обманутых клиентов другой компании с таким же названием. Ниже расскажем, как мы это исправили. Но сначала разберёмся, откуда вообще берётся такая путаница и почему с появлением нейросетей она стала бить по бизнесу заметно сильнее.
Это реальный кейс из практики нашего агентства: клиент с узнаваемой трёхбуквенной аббревиатурой в названии, о котором четыре из пяти популярных нейросетей на прямой вопрос о надёжности рассказывали чужие истории про жалобы, долги и обманутых клиентов другой компании с таким же названием. Ниже расскажем, как мы это исправили. Но сначала разберёмся, откуда вообще берётся такая путаница и почему с появлением нейросетей она стала бить по бизнесу заметно сильнее.
Дизамбигуация бренда: что это за проблема на самом деле
Путаница названий — явление старое и обыденное. Одинаковые аббревиатуры, похожие имена, омонимы, компании из разных регионов с одним названием. В лингвистике, маркетинге и юриспруденции задачу «развести» две сущности с одинаковым именем называют дизамбигуацией (от англ. disambiguation — устранение неоднозначности).
В Википедии вы наверняка видели страницы вида «АБВ (значения)». Это и есть дизамбигуация в чистом виде: список того, что может скрываться за одним словом.
Раньше эта проблема касалась в основном юристов (споры о товарных знаках) и была не критичной для поиска. Пользователь видел в выдаче десять ссылок, читал сниппеты и сам понимал, какая компания ему нужна.
В Википедии вы наверняка видели страницы вида «АБВ (значения)». Это и есть дизамбигуация в чистом виде: список того, что может скрываться за одним словом.
Раньше эта проблема касалась в основном юристов (споры о товарных знаках) и была не критичной для поиска. Пользователь видел в выдаче десять ссылок, читал сниппеты и сам понимал, какая компания ему нужна.
Почему в 2026 году проблема стала острее
Сейчас первое, что видит пользователь — не десять синих ссылок, а один сгенерированный ответ. Он формируется до перехода на сайт, часто без клика вообще. Если в этом ответе бренд спутан с кем-то другим, пользователь получает готовый неверный вывод ещё до того, как у компании появился шанс это исправить.
Чтобы собрать такой ответ, модель должна понять, о какой сущности (entity) идёт речь. Если у бренда слабые entity-сигналы, например, нет чёткой карточки организации, данные в разных источниках противоречат друг другу, то модель находит статистически похожие тексты и объединяет их. Так две разные компании «АБВ» превращаются в одну, а отзывы, судебные дела и жалобы одной приписываются другой.
Классический поисковик в такой ситуации показывает вам «смешанную» выдачу. Нейросеть показывает уверенный вывод. Разница принципиальная.
Чтобы собрать такой ответ, модель должна понять, о какой сущности (entity) идёт речь. Если у бренда слабые entity-сигналы, например, нет чёткой карточки организации, данные в разных источниках противоречат друг другу, то модель находит статистически похожие тексты и объединяет их. Так две разные компании «АБВ» превращаются в одну, а отзывы, судебные дела и жалобы одной приписываются другой.
Классический поисковик в такой ситуации показывает вам «смешанную» выдачу. Нейросеть показывает уверенный вывод. Разница принципиальная.
Источники путаницы: поисковики и нейросети
Важно развести эти два канала, потому что механика ошибок и методы исправления в них различаются.
Классические поисковики: Google и Яндекс
Здесь путаница возникает по знакомым причинам:
По брендовому запросу в выдаче появляются чужие отзывы, чужая карточка в колдунщике, чужой сайт в топе. Это неприятно, но пользователь всё ещё видит источники и может разобраться. Методы работы с этим — SEO, работа с карточками организации, вытеснение негатива — давно отработаны и подробно описаны в индустрии. Мы не будем на них останавливаться и сосредоточимся на втором канале — там, где методы работы пока только формируются.
- Омонимия названий — две компании с одинаковым именем в разных отраслях или регионах.
- Похожие названия конкурентов — «ТехноСервис» и «Техно-Сервис», «Альфа Строй» и «АльфаСтрой».
- Аббревиатуры — трёхбуквенные сокращения почти всегда имеют десятки «соседей»: от других компаний до медицинских терминов и госструктур.
- Ошибочные карточки — Яндекс или Google собрали карточку организации из данных нескольких компаний.
По брендовому запросу в выдаче появляются чужие отзывы, чужая карточка в колдунщике, чужой сайт в топе. Это неприятно, но пользователь всё ещё видит источники и может разобраться. Методы работы с этим — SEO, работа с карточками организации, вытеснение негатива — давно отработаны и подробно описаны в индустрии. Мы не будем на них останавливаться и сосредоточимся на втором канале — там, где методы работы пока только формируются.
Нейросети и AI-ответы
Почему LLM путают сущности:
- Нет устойчивой привязки сущности. Модель не имеет в "голове" отдельной записи «компания АБВ из Екатеринбурга, занимается промышленным оборудованием». У неё есть облако текстов, в которых встречается токен «АБВ». Если это облако неоднородное — ответ будет смешанным.
- Нет карточки в Wikidata / Wikipedia. Для большинства моделей это основные источники для идентификации организаций. Если у вашего бренда нет записи, а у "однофамильца" есть, то модель по умолчанию считает, что «АБВ" — это он.
- Нет разметки sameAs. Структурированные данные Organization с полем sameAs связывают ваш сайт с профилями в соцсетях, справочниках, Wikidata. Без этого связки модель не понимает, что сайт, карточка в Яндекс Бизнесе и страница в отраслевом каталоге — одна и та же сущность.
- Конфликтующие NAP-данные. Name / Address / Phone (Название, Адрес, Телефон) в разных источниках различаются: на сайте одно юрлицо, в 2ГИС другое написание названия, в соцсетях старый адрес. Каждое расхождение снижает уверенность модели в том, что перед ней одна компания, и повышает вероятность склейки с чужой.
- RAG-специфика. Многие AI-ответы (Perplexity, нейро-ответы Яндекса, режим поиска в ChatGPT, Google AI Overview) работают по схеме RAG (генерация с дополненной выборкой): модель в реальном времени подтягивает контекст из поисковой выдачи и генерирует ответ на его основе. Это означает, что вся путаница классической выдачи наследуется, но с двумя отягчающими обстоятельствами: модель «сглаживает» противоречия — вместо десяти разных сниппетов вы получаете один связный, но неверный вывод; пользователь часто не проверяет источники, даже если они указаны.
Чем это грозит бизнесу
Исследования поведения пользователей стабильно показывают одно: прямому ответу ИИ доверяют больше, чем ссылке в выдаче. Ответ выглядит как экспертное заключение, а не как список мнений. Он не требует усилий на проверку.
В классической выдаче негатив о чужой компании — это одна ссылка из десяти. В ответе нейросети — это весь ответ. Пользователь получает не «есть разные мнения», а «этой компании доверять нельзя». Репутационный ущерб при этом невидим для вас: человек не оставляет отзыв, не пишет в поддержку, не звонит. Он просто не становится клиентом. На практике это может выглядеть как необъяснимое падение конверсии из брендового трафика без видимой причины.
В классической выдаче негатив о чужой компании — это одна ссылка из десяти. В ответе нейросети — это весь ответ. Пользователь получает не «есть разные мнения», а «этой компании доверять нельзя». Репутационный ущерб при этом невидим для вас: человек не оставляет отзыв, не пишет в поддержку, не звонит. Он просто не становится клиентом. На практике это может выглядеть как необъяснимое падение конверсии из брендового трафика без видимой причины.
Как обнаружить проблему
Хорошая новость: диагностика не требует специальных инструментов. Плохая: её почти никто не делает регулярно.
Шаг 1. Промпт-тестирование
Раз в месяц (при активной репутационной работе — раз в неделю) задавайте прямые вопросы в нескольких нейросетях:
Проверяйте минимум в ChatGPT, YandexGPT (через Алису и нейро-ответы в поиске Яндекса), Perplexity, Google AI Overview, а также в DeepSeek и GigaChat, если ваша аудитория ими пользуется. Фиксируйте в таблице: дата, модель, промпт, ответ, тональность, источники (если модель их показывает).
Важно тестировать без авторизации и без истории. Используйте новый чат или работайте в режиме инкогнито Иначе модель подстроится под ваш контекст и результаты будут нерепрезентативны.
- «Можно ли доверять компании [название]?»
- «Отзывы о компании [название]»
- «[Название] — это мошенники?»
- «Чем занимается компания [название]?»
- «[Название] и [название конкурента / однофамильца] — это одна компания?»
Проверяйте минимум в ChatGPT, YandexGPT (через Алису и нейро-ответы в поиске Яндекса), Perplexity, Google AI Overview, а также в DeepSeek и GigaChat, если ваша аудитория ими пользуется. Фиксируйте в таблице: дата, модель, промпт, ответ, тональность, источники (если модель их показывает).
Важно тестировать без авторизации и без истории. Используйте новый чат или работайте в режиме инкогнито Иначе модель подстроится под ваш контекст и результаты будут нерепрезентативны.
Шаг 2. Мониторинг упоминаний бренда с негативными маркерами
Настройте отслеживание связок «[бренд] + мошенники / обман / не платят / развод / отзывы» в системах мониторинга. Если всплески негатива относятся к другому городу, другой отрасли, другим фамилиям — это признак омонима, а не вашей репутационной проблемы.
Шаг 3. Анализ брендового трафика в Яндекс Метрике
Посмотрите на брендовые запросы в отчётах по поисковым фразам. Обратите внимание на:
- доля «чистых» брендовых запросов vs запросов с хвостами чужой тематики («АБВ купить арматуру», если вы продаёте софт);
- показатель отказов по таким запросам — если он в 2−3 раза выше среднего по брендовому трафику, к вам приходят за другой компанией;
- запросы вида «[бренд] отзывы», «[бренд] мошенники» — их рост при отсутствии реального негатива у вас указывает на путаницу.
Шаг 4. Проверка выдачи и колдунщиков
Введите бренд в Яндекс и Google в режиме инкогнито, чтобы поисковик не подстраивал выдачу под вашу историю запросов и не показывал ваш сайт выше только потому, что вы на него часто заходите. Что показывается справа / сверху: ваша карточка, чужая, смешанная, или Википедия про другую компанию? Есть ли в выдаче страницы отзывов, где ваш бренд и чужой перемешаны?
Если хотя бы по одному из четырёх пунктов вы нашли проблему — переходим к решениям.
Если хотя бы по одному из четырёх пунктов вы нашли проблему — переходим к решениям.
Технические решения
Google: Knowledge Panel, Wikidata, sameAs
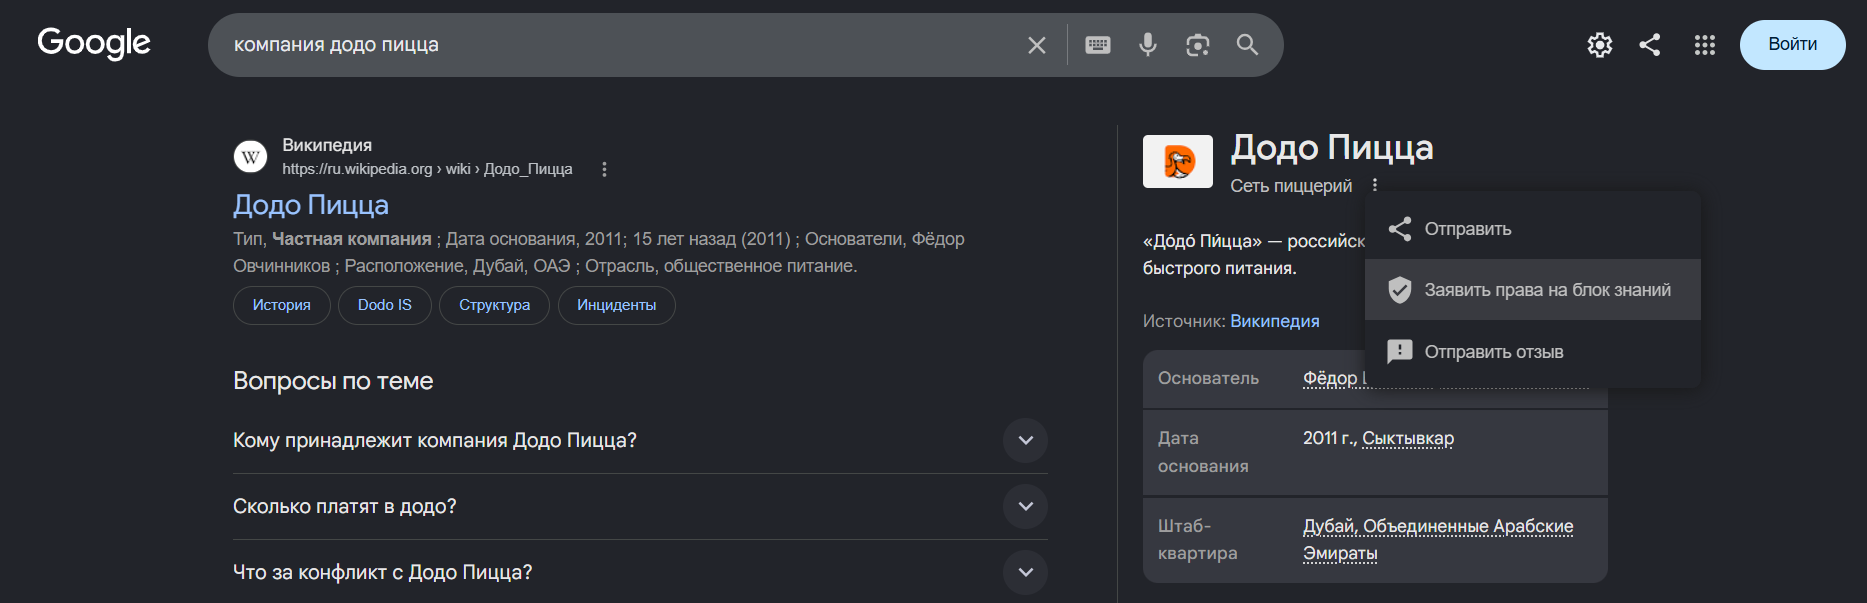
Knowledge Panel (Блок знаний). Это блок справа от результатов поиска с названием, логотипом, описанием и ссылками на компанию. Если такая панель по вашему бренду уже существует — заявите права на неё. Под панелью есть кнопка «Заявить права на блок знаний» (Claim this knowledge panel), потребуется подтвердить принадлежность через официальные аккаунты компании в соцсетях или через Google Search Console. После подтверждения вы сможете предлагать правки описания, логотипа и ссылок. Если блока нет — по заявке её не создают. Google формирует её сам, когда накопит достаточно подтверждений, что ваша компания — отдельная, узнаваемая сущность. Эти подтверждения и дают следующие пункты.
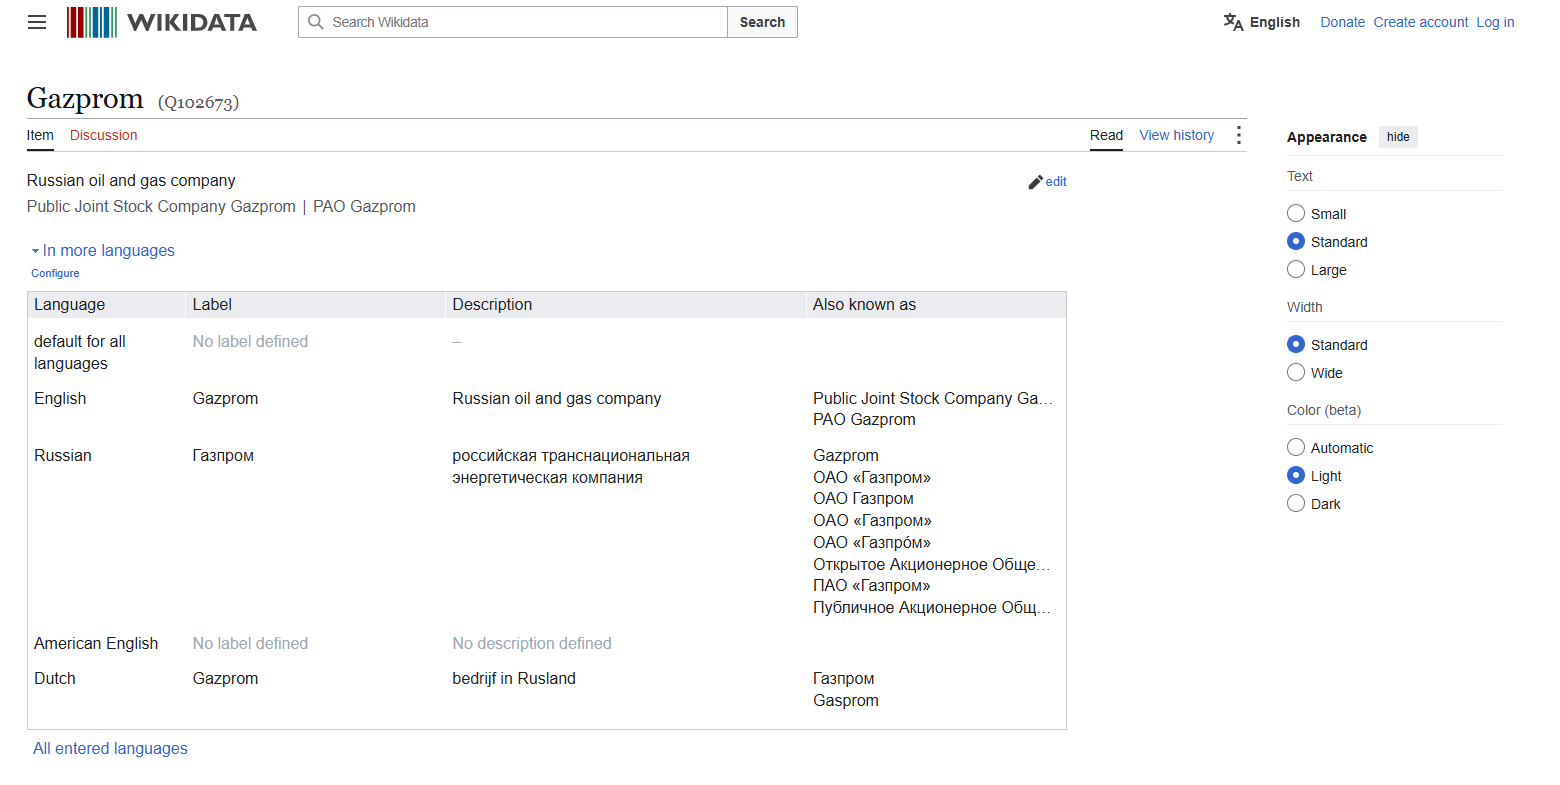
Wikidata (Викиданные). Создайте или дополните элемент организации: официальное название, альтернативные написания, ИНН/ОГРН (есть соответствующие свойства), сфера деятельности, штаб-квартира, дата основания, официальный сайт, ссылки на профили в соцсетях. Wikidata требует ссылок на источники — подойдут ЕГРЮЛ, отраслевые СМИ, официальные реестры. Не пишите промо-текст: удалят вместе с элементом.
Микроразметка Organization. На главной странице и странице «О компании» разместите микроразметку Organization (или её подтип: LocalBusiness, ProfessionalService и т. д.) с максимальным заполнением: name, alternateName, legalName, url, logo, description, address, telephone, foundingDate, founder, taxID / vatID, и обязательно sameAs — массив ссылок на все ваши официальные профили: Wikidata, соцсети, Яндекс Бизнес, 2ГИС, отраслевые каталоги, если есть.
Единообразие названия, адреса и телефона (NAP — Name, Address, Phone). Во всех источниках компания должна называться одинаково — слово в слово. Если на сайте написано «ООО АБВ», в Яндекс Бизнесе — «АБВ Групп», а в 2ГИС — «Компания АБВ», для поисковика и нейросети это три разные организации, а не одна. То же касается адреса (не «ул. Ленина, 5» в одном месте и «Ленина 5, офис 12» в другом) и телефона (один формат записи везде). Выберите одно основное написание — как правило, то, что указано на сайте и в учредительных документах, — и приведите к нему все остальные площадки.
Единообразие названия, адреса и телефона (NAP — Name, Address, Phone). Во всех источниках компания должна называться одинаково — слово в слово. Если на сайте написано «ООО АБВ», в Яндекс Бизнесе — «АБВ Групп», а в 2ГИС — «Компания АБВ», для поисковика и нейросети это три разные организации, а не одна. То же касается адреса (не «ул. Ленина, 5» в одном месте и «Ленина 5, офис 12» в другом) и телефона (один формат записи везде). Выберите одно основное написание — как правило, то, что указано на сайте и в учредительных документах, — и приведите к нему все остальные площадки.
Яндекс: Яндекс Бизнес, карточка организации и Википедия / РуВики
Для российского рынка это основной канал, и здесь важна последовательность шагов.
Шаг 1. Найдите дубли и чужие карточки в Яндекс Бизнесе. Введите название в Яндекс Картах и в Яндекс Бизнесе. Часто обнаруживается: две-три карточки вашей компании (старый адрес, филиал, автосозданная карточка) плюс карточки других организаций с тем же названием. Дубли своих — объединить через поддержку Яндекс Бизнеса. Чужие — убедиться, что у них указан другой вид деятельности и регион, при необходимости пожаловаться на некорректные данные. Это первое, что нужно исправить технически, потому что карточка организации — основной источник данных для Алисы и нейро-ответов Яндекса.
Шаг 2. Сверьте NAP. Карточка в Яндекс Бизнесе, сайт, 2ГИС, соцсети (ВКонтакте, Telegram), отраслевые каталоги, Rusprofile / Checko и подобные агрегаторы юрлиц. Составьте таблицу и приведите всё к одному написанию.
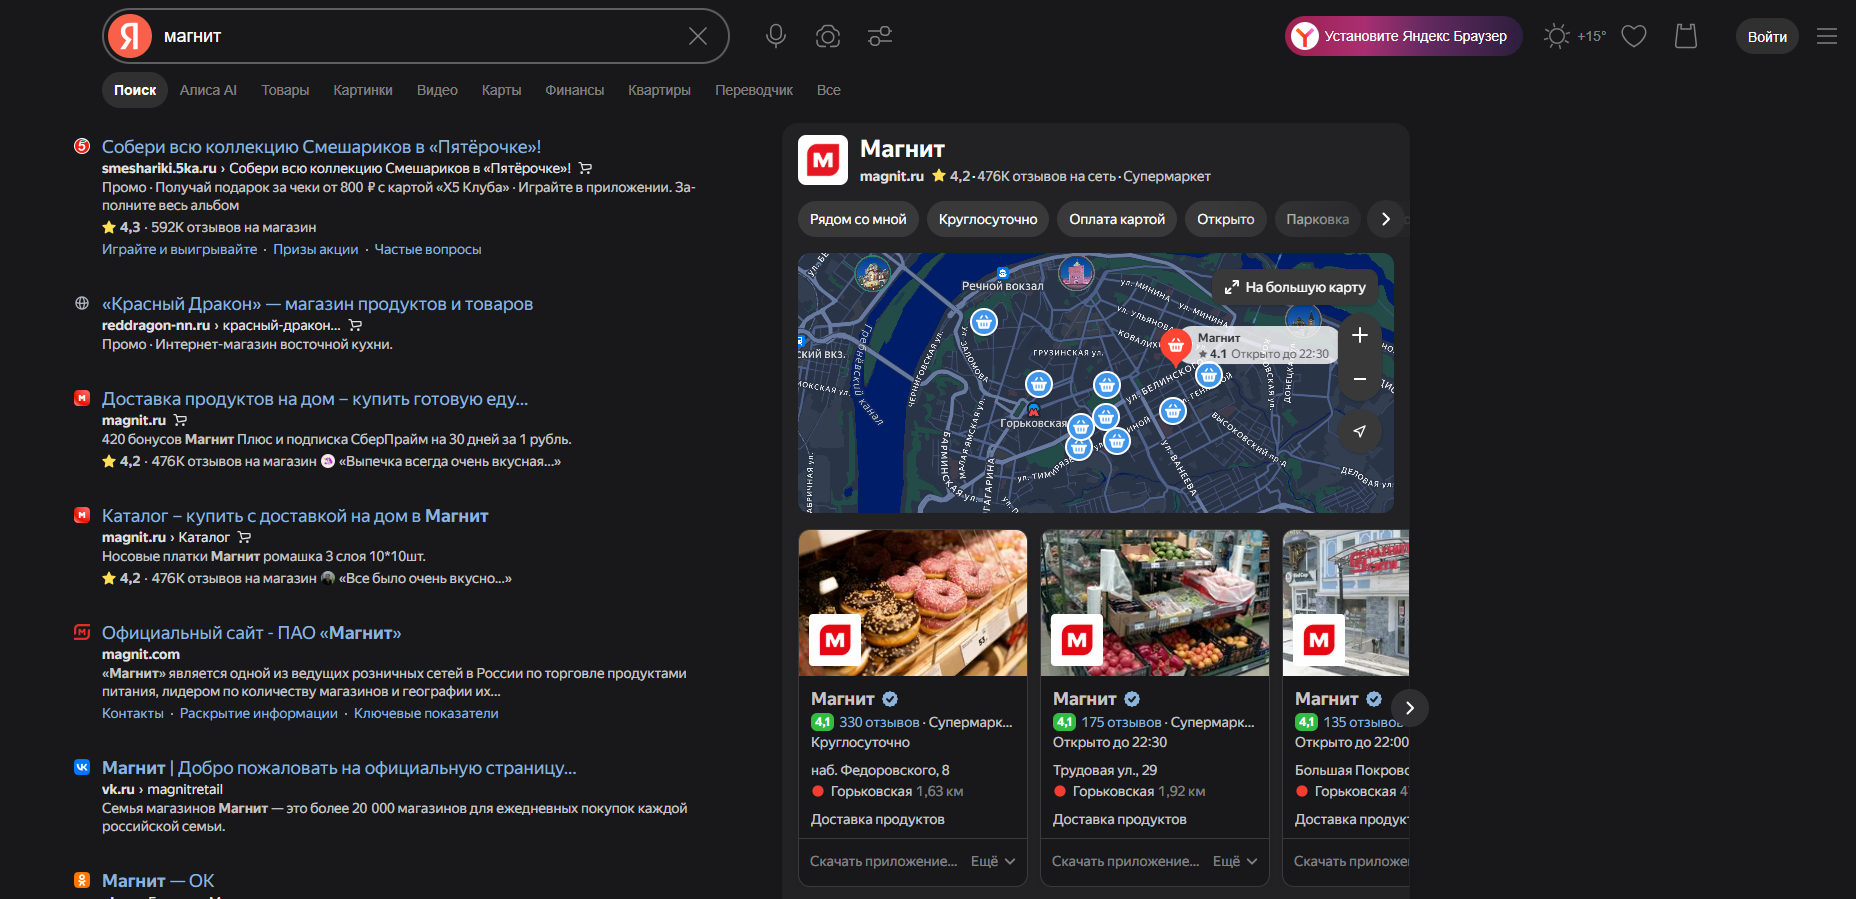
Шаг 3. Проверьте колдунщик по брендовому запросу. Что Яндекс показывает по запросу с вашим названием: вашу карточку, чужую, объектный ответ из Википедии про другую сущность? Если чужую — значит, Яндекс считает более «сильной» сущностью не вас. Исправляется усилением ваших entity-сигналов (шаги 1−2, разметка, упоминания в авторитетных источниках) и, при явной ошибке, обращением в поддержку.
Шаг 1. Найдите дубли и чужие карточки в Яндекс Бизнесе. Введите название в Яндекс Картах и в Яндекс Бизнесе. Часто обнаруживается: две-три карточки вашей компании (старый адрес, филиал, автосозданная карточка) плюс карточки других организаций с тем же названием. Дубли своих — объединить через поддержку Яндекс Бизнеса. Чужие — убедиться, что у них указан другой вид деятельности и регион, при необходимости пожаловаться на некорректные данные. Это первое, что нужно исправить технически, потому что карточка организации — основной источник данных для Алисы и нейро-ответов Яндекса.
Шаг 2. Сверьте NAP. Карточка в Яндекс Бизнесе, сайт, 2ГИС, соцсети (ВКонтакте, Telegram), отраслевые каталоги, Rusprofile / Checko и подобные агрегаторы юрлиц. Составьте таблицу и приведите всё к одному написанию.
Шаг 3. Проверьте колдунщик по брендовому запросу. Что Яндекс показывает по запросу с вашим названием: вашу карточку, чужую, объектный ответ из Википедии про другую сущность? Если чужую — значит, Яндекс считает более «сильной» сущностью не вас. Исправляется усилением ваших entity-сигналов (шаги 1−2, разметка, упоминания в авторитетных источниках) и, при явной ошибке, обращением в поддержку.
Шаг 4. Википедия / РуВики — первичны для обеих систем. Если по вашему названию есть статья в Википедии про другую организацию — она будет побеждать по умолчанию и в Яндексе, и в Google, и во всех нейросетях. Варианты: добиться создания страницы значений (дизамбигуации) с указанием вашей компании; при соответствии критериям значимости — создать статью о вашей организации (это сложно, требует независимых авторитетных источников и не делается «через знакомого редактора» — такие статьи быстро удаляют). Если критериям не соответствуете — усиливайте Wikidata, там требования мягче.
Нейросети и AEO: как исправить ответы ИИ о бренде
Это ключевой блок. Прямого «редактора ответов» у нейросетей нет — нельзя написать в OpenAI и попросить поправить. Работать нужно с тем, откуда модель берёт информацию.
- Насыщение авторитетных источников однозначным описанием. Модель должна много раз встретить формулировку вида «АБВ — [сфера деятельности] компания из [город], основана в [год], специализируется на [конкретика]». Каналы: отраслевые СМИ, деловые издания, профильные каталоги, интервью руководителей, пресс-релизы на площадках с высоким авторитетом, страницы партнёров и клиентов («наш поставщик АБВ — производитель…»). Каждое такое упоминание — плюс к устойчивости сущности. Важно: формулировка должна быть одинаковой по смыслу везде.
- Структурированные данные Organization по максимуму. Не три поля, а все, которые применимы. Особое внимание — description (короткое однозначное описание сферы деятельности), alternateName (все варианты написания, включая латиницу), sameAs, knowsAbout (тематики экспертизы), areaServed.
- Страница дизамбигуации на сайте (страница «Это не мы»). Создайте страницу с прямым разграничением: «Компания АБВ (наш сайт) — производитель промышленного оборудования из Екатеринбурга. Мы не имеем отношения к ООО „АБВ“ из Краснодара (сфера — грузоперевозки), ООО „АБВ-Строй“ и другим организациям с похожими названиями». Укажите ваши реквизиты, подчеркните различия. Эта страница решает три задачи: даёт ИИ-системам готовый фрагмент для ответа на вопрос «АБВ и АБВ — одна компания?», ранжируется по запросам с путаницей и снимает вопросы у людей, которые уже сомневаются.
- Работа с конкретными источниками негатива. Выясните, откуда именно нейросеть берёт негатив. Perplexity и нейро-ответы Яндекса показывают источники напрямую; в ChatGPT с поиском можно попросить «укажи источники». В 80% случаев это один-два агрегатора отзывов (Otzovik, IRecommend, Flamp, Яндекс Карты чужой карточки) или страница на сайте-«антимошенническом» рейтинге. Дальше — по ситуации: запрос на разделение страниц компаний с одинаковым названием, уточнение города/сферы в карточке на агрегаторе, официальный комментарий от вашей компании на этой странице с указанием, что вы — другая организация. Комментарий сам становится текстом, который модель подтянет в следующий раз.
- Собственный контент с entity-плотностью. Страница «О компании», история, команда, реквизиты, лицензии, кейсы с названиями клиентов. Чем больше уникальных, проверяемых фактов связано с вашим названием, тем сложнее модели спутать вас с кем-то ещё.
Кейс: как мы исправили ответы нейросетей о компании
Ниже — реальный проект агентства. Название клиента заменено на условную аббревиатуру АБВ по соглашению о конфиденциальности, цифры округлены.
Ситуация
Клиент — оптовая торговая компания с трёхбуквенным названием, работает в B2B-сегменте более 10 лет: поставляет оборудование и расходные материалы предприятиям. Клиенты — юрлица, средний чек — сотни тысяч рублей, решение о закупке принимает несколько человек, и поставщика перед первым заказом проверяют: смотрят реквизиты, отзывы, задают вопросы нейросетям.
Обратились с жалобой: менеджеры отдела продаж стали слышать от потенциальных заказчиков фразы вида «мы посмотрели про вас — там пишут про обманутых клиентов и невозврат денег». При этом реальных претензий, судебных споров и негативных отзывов у компании не было.
Обратились с жалобой: менеджеры отдела продаж стали слышать от потенциальных заказчиков фразы вида «мы посмотрели про вас — там пишут про обманутых клиентов и невозврат денег». При этом реальных претензий, судебных споров и негативных отзывов у компании не было.
Диагностика
Провели промпт-тестирование: 10 типовых запросов в 5 системах (ChatGPT, YandexGPT/Алиса, Perplexity, Google AI Overview, DeepSeek), по 3 прогона на каждый промпт без авторизации.
Результат: 4 из 5 систем на вопрос «можно ли доверять компании АБВ» возвращали негативный или предостерегающий ответ. Доля корректных ответов (правильная сфера деятельности, правильный город, нейтральная или положительная тональность) — около 20%.
Источник негатива нашли прямо в ответах нейросетей: большинство из них показывают ссылки на источники под каждым утверждением. Все ссылки вели на страницы про три другие компании с таким же названием:
Нейросети смешивали эти три сюжета в один: клиенту приписывали и «невозврат предоплаты», и «жалобы на коллекторов» одновременно — хотя он никогда не работал ни с займами, ни с розничными покупателями. Записи в Викиданных (Wikidata) не было ни у одной из компаний, а разметка Organization (структурированные данные об организации) на сайте клиента содержала только название и адрес сайта — без описания сферы деятельности, реквизитов и ссылок на официальные профили.
Результат: 4 из 5 систем на вопрос «можно ли доверять компании АБВ» возвращали негативный или предостерегающий ответ. Доля корректных ответов (правильная сфера деятельности, правильный город, нейтральная или положительная тональность) — около 20%.
Источник негатива нашли прямо в ответах нейросетей: большинство из них показывают ссылки на источники под каждым утверждением. Все ссылки вели на страницы про три другие компании с таким же названием:
- финансовую компанию, выдававшую займы населению — несколько десятков отзывов на агрегаторе с жалобами на скрытые комиссии и звонки коллекторов;
- интернет-магазин, который брал предоплату и не отправлял товар — тема в сообществе обманутых покупателей и пара публикаций в региональных СМИ;
- иностранную фирму из сферы услуг, закрывшуюся несколько лет назад с невозвращёнными деньгами клиентов — страница на сайте-«чёрном списке» недобросовестных компаний.
Нейросети смешивали эти три сюжета в один: клиенту приписывали и «невозврат предоплаты», и «жалобы на коллекторов» одновременно — хотя он никогда не работал ни с займами, ни с розничными покупателями. Записи в Викиданных (Wikidata) не было ни у одной из компаний, а разметка Organization (структурированные данные об организации) на сайте клиента содержала только название и адрес сайта — без описания сферы деятельности, реквизитов и ссылок на официальные профили.
Что сделали
- Яндекс Бизнес — проверили и обновили карточки организации, объединили филиалы, заполнили карточки полностью.
- NAP-аудит — привели к единому написанию данные в 14 источниках: сайт, 2ГИС, соцсети, отраслевые каталоги, агрегаторы юрлиц.
- Микроразметка Organization — расширили до 20+ полей с sameAs на все официальные профили, alternateName с вариантами написания.
- Wikidata — создали элемент организации с реквизитами, сферой деятельности, ссылками на источники.
- Страница дизамбигуации на сайте с явным разграничением от одноимённых компаний, реквизитами, картой.
- Внешние публикации — 6 материалов в отраслевых и деловых СМИ с единообразным описанием компании и упоминанием руководства.
- Ежемесячные контрольные замеры по той же таблице промптов.
Результат
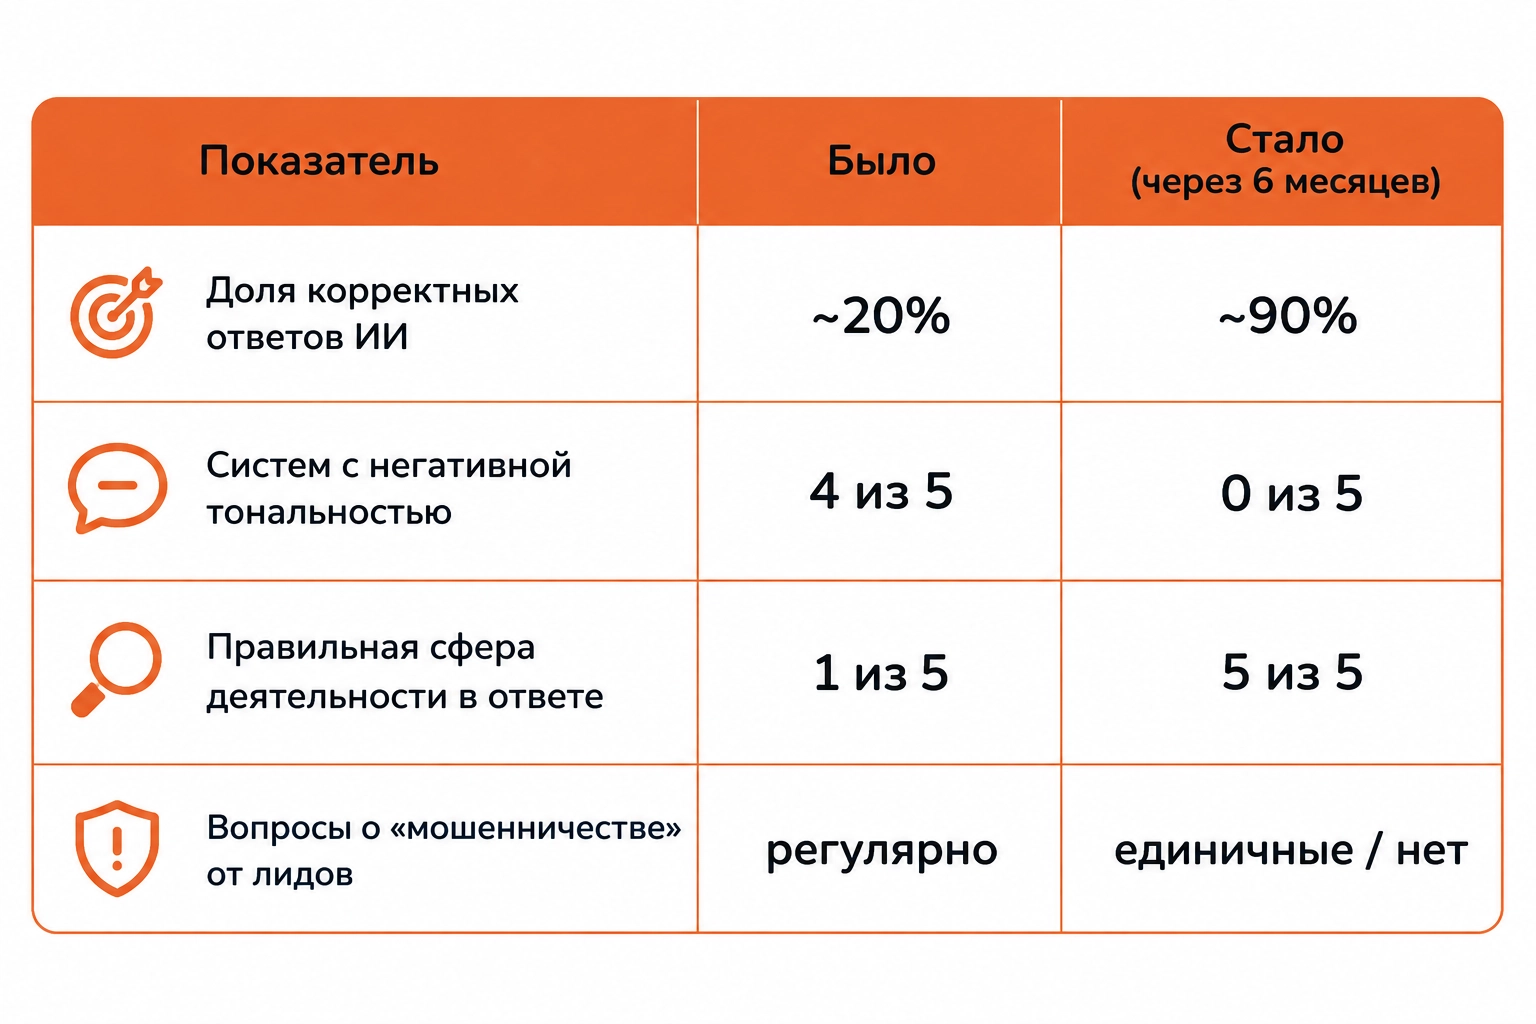
Первые изменения в нейро-ответах Яндекса и Perplexity появились через 3−4 недели — сразу после переиндексации карточек и разметки. ChatGPT в режиме поиска — через 6−8 недель. Полностью стабильный результат — 6 месяцев.
Вывод
Проблема с ответами нейросетей решается системной работой с entity-сигналами — теми же, что лежат в основе классического SEO, но с поправкой на то, как модели собирают ответ. Именно поэтому дизамбигуацию мы делаем в связке GEO + SEO + SERM.
Путаница названий существовала всегда, но нейросети превратили её в прямой репутационный риск: неверный ответ ИИ выглядит убедительнее любой ссылки и не оставляет пользователю повода проверить источник. Исправить это можно — но не письмом в поддержку, а системной работой с сущностью бренда во всех источниках, из которых модели собирают ответы.
Путаница названий существовала всегда, но нейросети превратили её в прямой репутационный риск: неверный ответ ИИ выглядит убедительнее любой ссылки и не оставляет пользователю повода проверить источник. Исправить это можно — но не письмом в поддержку, а системной работой с сущностью бренда во всех источниках, из которых модели собирают ответы.
Если вы подозреваете, что нейросети или поисковики путают вашу компанию с другой — начните с экспресс-аудита. Покажем, что именно ChatGPT, Алиса, Perplexity и Google говорят о вашем бренде, откуда берут данные и что нужно исправить в первую очередь.
Заказать аудит →
Заказать аудит →
Частые вопросы
Что такое дизамбигуация бренда простыми словами?
Это устранение путаницы между компаниями с одинаковыми или похожими названиями — чтобы поисковики, нейросети и люди однозначно понимали, о какой организации речь. Технически — набор работ по усилению «сигналов сущности»: карточки, разметка, единообразные данные, авторитетные упоминания.
Можно ли удалить неверную информацию из ChatGPT или Алисы?
Напрямую — нет, у нейросетей нет функции редактирования ответов о компаниях. Но можно изменить источники, из которых они собирают ответ: карточки организаций, разметку, справочники, публикации, страницы отзывов. Ответы меняются вслед за источниками.
Сколько времени занимает исправление путаницы бренда в ИИ-ответах?
Системы с поиском в реальном времени (нейро-ответы Яндекса, Perplexity, ChatGPT с поиском, Google AI Overview) реагируют через 3−8 недель после исправления источников. Устойчивый результат по всем каналам — обычно 3−6 месяцев. Модели без доступа к поиску обновляются только с выходом новой версии.
Что такое AEO и GEO и как это связано с путаницей бренда?
AEO (Answer Engine Optimization) и GEO (Generative Engine Optimization) — оптимизация присутствия бренда в ответах нейросетей и AI-поиска. Дизамбигуация — базовая часть этой работы: пока модель путает вас с другой компанией, любое продвижение в ИИ-ответах работает на чужую репутацию.
Это устранение путаницы между компаниями с одинаковыми или похожими названиями — чтобы поисковики, нейросети и люди однозначно понимали, о какой организации речь. Технически — набор работ по усилению «сигналов сущности»: карточки, разметка, единообразные данные, авторитетные упоминания.
Можно ли удалить неверную информацию из ChatGPT или Алисы?
Напрямую — нет, у нейросетей нет функции редактирования ответов о компаниях. Но можно изменить источники, из которых они собирают ответ: карточки организаций, разметку, справочники, публикации, страницы отзывов. Ответы меняются вслед за источниками.
Сколько времени занимает исправление путаницы бренда в ИИ-ответах?
Системы с поиском в реальном времени (нейро-ответы Яндекса, Perplexity, ChatGPT с поиском, Google AI Overview) реагируют через 3−8 недель после исправления источников. Устойчивый результат по всем каналам — обычно 3−6 месяцев. Модели без доступа к поиску обновляются только с выходом новой версии.
Что такое AEO и GEO и как это связано с путаницей бренда?
AEO (Answer Engine Optimization) и GEO (Generative Engine Optimization) — оптимизация присутствия бренда в ответах нейросетей и AI-поиска. Дизамбигуация — базовая часть этой работы: пока модель путает вас с другой компанией, любое продвижение в ИИ-ответах работает на чужую репутацию.

Читайте первыми
Будьте в курсе новых публикаций раньше других. Оставьте свой email — и мы сообщим, как только выйдет что-то интересное.
Смотрите также

Как нейросети перекраивают воронку продаж: от первого вопроса до повторной записи

Доверять ли алгоритмам полностью: можно ли вести Яндекс Директ через нейросеть без специалиста в 2026

Реклама в YouTube и Telegram в 2026 году: что запрещено, кому грозит штраф и что делать бизнесу

От SEO к GEO и AIO: как попасть в рекомендации ИИ-поисковиков