SEO умер? Нет. Просто он заканчивается на границе вашего сайта
Разбор: какие 70% SEO-работ нужны для продвижения в нейросетях, какие — спорны, а какие вы оплачиваете зря.
SEO хоронили при появлении соцсетей. Потом при Panda и Penguin. Потом при mobile-first, потом при нулевых кликах. Каждый раз умирала не дисциплина, а конкретный набор практик — закупка ссылок пачками, тексты с плотностью ключей 7%, дорвеи, — и каждый раз рынок путал одно с другим.
Сейчас хоронят снова, и повод серьёзнее прежних: пользователь всё чаще получает ответ, не открывая ни одного сайта. Но вывод из этого делают неверный. Проблема не в том, что SEO перестало работать. Проблема в том, что SEO всегда работало внутри вашего сайта — а нейросеть собирает ответ преимущественно снаружи.
Ниже — инвентаризация. Мы взяли типовой перечень работ из SEO-договора и разложили каждый пункт по трём корзинам: работает на видимость в ИИ, спорно, не работает вообще. С опорой на исследования, а не на ощущения.
Два контура
Весь спор «SEO или GEO» снимается одной схемой.
Внутренний контур — это SEO. Техническая доступность, индексируемость, структура, контент, фактура на странице. Всё, что вы контролируете напрямую, потому что это ваш домен.
Внешний контур — это GEO. Площадки, которые цитируют модели: сообщества, отзовики, агрегаторы, отраслевые медиа, профессиональные соцсети, видео. Всё, что вы не контролируете, но на что можете влиять.
Между ними принципиальная разница в функции:
Внутренний контур — условие допуска. Внешний контур — условие выбора.
Сайт, который технически непригоден для извлечения, не процитируют никогда. Но сайт, о котором нигде не говорят, модель просто не встретит в источниках — и тоже не процитирует. Это не два альтернативных подхода. Это два этажа одного здания, и построить можно только оба.
Как нейросеть собирает ответ
Механика важна, потому что из неё следует всё остальное.
Модель не «знает» ответ про ваш товар. Когда пользователь задаёт вопрос, система ищет, забирает несколько документов и пересобирает из них связный текст. Значит, страницу нужно сначала найти, потом получить, потом понять — ровно те три задачи, которые SEO решало двадцать лет.
Но есть второе следствие, менее очевидное и гораздо более важное: документы, из которых собирается ответ, чаще всего не ваш сайт. По данным Semrush за январь 2026, два самых цитируемых домена в ChatGPT, Perplexity и Google AI Mode — это Reddit и LinkedIn (разбор на Backlinko). Не сайты брендов. Не корпоративные блоги. Пользовательские обсуждения и профессиональная соцсеть.
Решение о том, назовёт ли модель вашу компанию, принимается на чужих площадках.
И ещё одна деталь, ломающая привычную логику отчётности. В ИИ-выдаче нет позиций — не в переносном смысле, а буквально. Исследование показало, что одинаковый список рекомендованных брендов нейросети выдают реже чем в 1 случае из 100, а одинаковый порядок — реже чем в 1 из 1000. Поэтому вопрос «на каком мы месте в ChatGPT» некорректен по своей природе. Корректный вопрос: как часто бренд появляется на репрезентативной выборке промптов.
Откуда взялись 70%
Чтобы цифра в заголовке не была кликбейтом, объясним методику.
Мы взяли реальный перечень работ из типового SEO-договора — около сорока позиций: техаудит, скорость загрузки, метатеги, перелинковка, тексты на категории, закупка ссылок, микроразметка, региональность, поведенческие и так далее. Каждую позицию разложили по трём корзинам: прямое влияние на видимость в ИИ, спорное влияние, нулевое. Для каждой корзины зафиксировали основание — исследование, официальную документацию или собственный замер.
Получилось примерно 70% работ, сохраняющих ценность, и около 30% балласта.
Важная поправка к трактовке. Эти 70% не означают, что SEO и есть GEO. Они означают, что 70% привычных SEO-работ остаются нужными — но закрывают только нижний этаж. Верхний этаж SEO не строит вообще, его там не было никогда.
Оговорка о границах применимости: пропорция зависит от ниши и от исходного состояния сайта. На запущенном проекте доля полезных технических работ будет выше, на вылизанном — ниже, потому что фундамент уже залит.
Корзина № 1. Гигиена допуска — те самые 70%
У каждого пункта ниже один и тот же рефрен: без этого вас не процитируют, но одного этого недостаточно, чтобы вас назвали.
Доступ для ИИ-краулеров. GPTBot, PerplexityBot, Google-Extended и другие агенты должны иметь доступ к сайту. Это самая частая и самая обидная находка в аудитах: компания платит за продвижение, а в robots.txt стоит запрет — иногда поставленный сознательно пару лет назад из соображений защиты контента, иногда унаследованный от прошлого подрядчика. Проверяется за пять минут, стоит потенциально всей видимости.
Индексируемость. Канонические адреса, карта сайта, отсутствие мусорных дублей, доступность контента без JavaScript-рендеринга. Классика, которая никуда не делась.
Извлекаемая структура. Внятные подзаголовки, прямой ответ на вопрос в первом абзаце раздела, списки, таблицы, определения. Модель вытаскивает из документа фрагмент — и чем чище этот фрагмент отделяется от остального текста, тем выше шанс, что вытащат именно его. Хорошие SEO-редакторы делали это годами ради расширенных сниппетов; теперь та же работа окупается дважды.
Фактура на странице. Цены, условия, сроки, характеристики, сравнения, ограничения. Это то, что модель может пересказать, отвечая на транзакционный запрос. Страница с маркетинговыми обещаниями без единой конкретной цифры для нейросети пуста.
Актуальность данных. Устаревшие цифры — распространённая причина, по которой в ответе окажется конкурент. Модели чувствительны к датам и свежести.
E-E-A-T и авторство. Реальные авторы с профилями, подтверждённая экспертиза, единообразие названия компании, описания и категории во всех упоминаниях. Последнее особенно важно: разнобой в написании бренда размывает его как сущность.
Корзина № 2. Серая зона: где продают воздух
Это блок, который большинство агентств писать не станет, — потому что продаёт именно это.
Микроразметка Schema.org
Google прямо документирует: для ИИ-функций специальная разметка не требуется. Тест Ahrefs по схеме «до/после» на 1885 страницах не показал значимого прироста цитируемости ни в AI Mode, ни в ChatGPT. При этом существует и встречная академическая работа, проверяющая обратную гипотезу — исследование на SSRN, 2026. Сводный разбор доказательной базы с обеих сторон — здесь.
Вердикт: разметку делаем ради классической выдачи, где её польза доказана. Продавать как инструмент GEO — некорректно.
Вердикт: разметку делаем ради классической выдачи, где её польза доказана. Продавать как инструмент GEO — некорректно.
llms.txt
По данным Ahrefs, 97% размещённых файлов llms.txt не получили ни одного запроса. Позиция Google: «не поможет и не навредит».
Но есть задокументированный по логам контркейс. Команда dev5310 отправила файл напрямую в Search Console 2 февраля 2026 — без ссылок и без записи в sitemap. Google проиндексировал его в тот же день. 3 февраля Google AI Mode процитировал файл как источник № 1. К 20 февраля — цитирование в трёх запросах из четырёх по разным темам, за четыре дня файл запросили шесть подтверждённых ИИ-ботов.
Вердикт: единичный кейс против выборки в тысячи файлов. Час работы — да. Строчка в KPI — нет.
Скорость загрузки
Для пользователя и для классического ранжирования — критично. Для модели, которая забирает HTML, влияние минимально.
Обратите внимание на закономерность: все три спорные гипотезы — внутренние, «сайтовые». Именно поэтому эффект от них такой слабый. Рычаг находится снаружи.
Обратите внимание на закономерность: все три спорные гипотезы — внутренние, «сайтовые». Именно поэтому эффект от них такой слабый. Рычаг находится снаружи.
Корзина № 3. Балласт — те самые 30%
- Погоня за позициями по частотным однословникам. В ИИ-выдаче позиций нет — см. цифры 1/100 и 1/1000 выше.
- Массовая закупка дешёвых ссылок с нерелевантных доноров. Подробнее — в следующем разделе, там для этого есть убийственная цифра.
- Тексты «под объём». Вода снижает шанс быть извлечённым: размывается тот самый чистый фрагмент.
- Страницы-клоны под микрочастотку. Работали на охват в классическом поиске, в ИИ не дают ничего.
- Оптимизация метатегов как самоцель. В ответ модели title не попадает.
- Накрутка поведенческих.
- Отчётность, построенная на трафике из нейросетей. Отдельный пункт, который стоит понять до подписания договора: 9 октября 2026 реферальный трафик из ChatGPT упал почти вдвое за сутки (LLM Pulse). Причина — на стороне платформы. Метрика, которую чужой релиз может обнулить за ночь, не может быть главной в отчёте подрядчика.
Внешний контур: то, чего в SEO не было никогда
Здесь начинается GEO как отдельная дисциплина. И здесь же — самая весомая доказательная база из всех, что есть на сегодня.
Что показали 75 000 брендов
Ahrefs проанализировал 75 000 брендов и миллионы ИИ-ответов в ChatGPT, Gemini, Copilot, Perplexity, AI Overviews и AI Mode (исследование по AI Overviews, по остальным платформам).
Вот как факторы коррелируют с видимостью бренда в ИИ-ответах, от сильного к слабому:
Три вывода.
Первый. Топ-3 фактора — все внешние. Не структура сайта, не разметка, не скорость. Присутствие бренда в инфополе.
Второй, самый болезненный для рынка. Упоминания бренда коррелируют с видимостью в ИИ втрое сильнее, чем обратные ссылки — 0,664 против 0,218. Моделям важен факт разговора о вас, а не гиперссылка. Это ставит крест на закупке ссылочного ради ссылочного и переводит бюджет туда, где он работает: в реальные упоминания на площадках, которым доверяют модели.
Третий. В более позднем замере сильнее всего коррелировали упоминания на YouTube и их охваты — обогнав даже брендовые веб-упоминания. Внешний контур включает видео, и это отдельное направление работ.
Служебная цифра для калибровки ожиданий: около 26% брендов выборки не имели в ИИ-ответах ни одного упоминания. Четверть рынка в нейросетях не существует.
Что показали 75 000 брендов
Ahrefs проанализировал 75 000 брендов и миллионы ИИ-ответов в ChatGPT, Gemini, Copilot, Perplexity, AI Overviews и AI Mode (исследование по AI Overviews, по остальным платформам).
Вот как факторы коррелируют с видимостью бренда в ИИ-ответах, от сильного к слабому:
- Брендовые упоминания в вебе — 0,664. Внешний фактор.
- Брендовые анкоры — 0,527. Внешний фактор.
- Объём брендового поиска — 0,392. Внешний фактор.
- Обратные ссылки — 0,218. Ссылочный фактор.
- Брендовый рекламный трафик — 0,216. Платный фактор.
Три вывода.
Первый. Топ-3 фактора — все внешние. Не структура сайта, не разметка, не скорость. Присутствие бренда в инфополе.
Второй, самый болезненный для рынка. Упоминания бренда коррелируют с видимостью в ИИ втрое сильнее, чем обратные ссылки — 0,664 против 0,218. Моделям важен факт разговора о вас, а не гиперссылка. Это ставит крест на закупке ссылочного ради ссылочного и переводит бюджет туда, где он работает: в реальные упоминания на площадках, которым доверяют модели.
Третий. В более позднем замере сильнее всего коррелировали упоминания на YouTube и их охваты — обогнав даже брендовые веб-упоминания. Внешний контур включает видео, и это отдельное направление работ.
Служебная цифра для калибровки ожиданий: около 26% брендов выборки не имели в ИИ-ответах ни одного упоминания. Четверть рынка в нейросетях не существует.
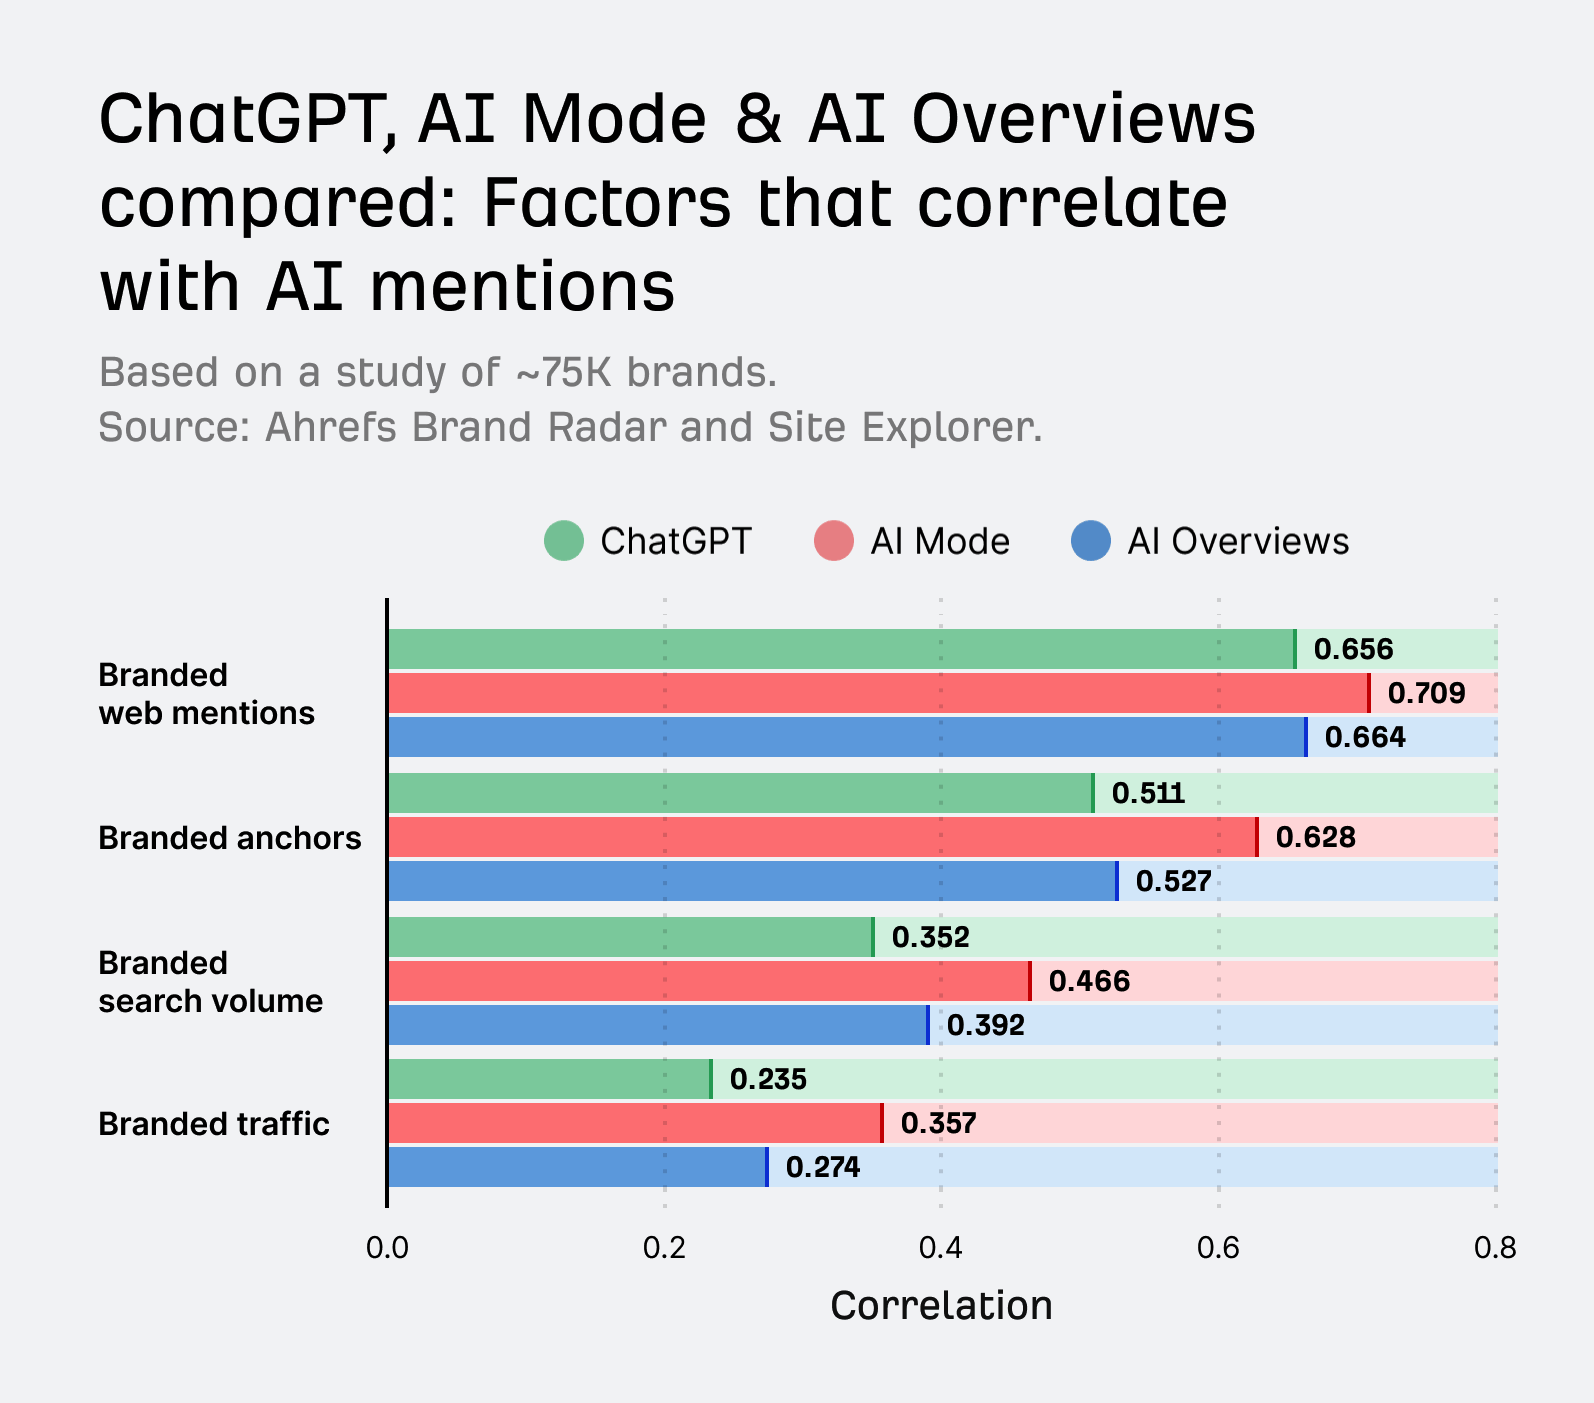
Честная оговорка. Корреляция не равна причинности. Сильные бренды одновременно и чаще упоминаются, и чаще попадают в ИИ-ответы — часть связи объясняется общим фактором силы бренда. Корректная формулировка: упоминания — лучший из известных на сегодня предикторов видимости в нейросетях. Не гарантия, но самый надёжный ориентир из доступных.
Из чего состоит работа во внешнем контуре
Карта источников ниши. Первый шаг — не публикации, а разведка. Прогоняется выборка промптов и фиксируется, какие домены модели реально цитируют именно в вашей тематике. Reddit и LinkedIn — общая картина по рынку; в B2B-софте, медицине и строительстве списки источников будут разными.
Работа с сообществами и UGC. Там, где аудитория обсуждает выбор, модель берёт формулировки. Это не про рассылку рекламных постов — такие быстро удаляются и портят тональность. Это про системное экспертное присутствие.
Отзовики, агрегаторы, рейтинги, маркетплейсы. Классические источники сравнительных ответов на запросы вида «что лучше» и «альтернативы X».
Экспертные публикации и комментарии в отраслевых медиа. По сути, обычный PR — но с одним отличием: площадки отбираются не по охвату и не по медиакиту, а по критерию цитируемости моделями.
Видео. С учётом данных по YouTube — полноценное направление, а не приятное дополнение.
Консистентность сущности бренда. Единое написание названия, одинаковое описание, одна категория, непротиворечивые цифры во всех источниках. Разнобой мешает модели собрать вас в единую сущность.
Управление тональностью. Модель не только называет бренд — она его характеризует. «Надёжный, но дорогой» и «дешёвый, но с проблемами поддержки» — два разных коммерческих результата при одинаковом факте упоминания. Это новый репутационный KPI, которого в SEO не существовало.
Брендовый спрос как отложенный эффект. Рост брендовых запросов подпитывает сущность бренда в моделях, а цитирование в ИИ, в свою очередь, подпитывает брендовый спрос (LLM Pulse). Корреляция 0,392 из списка выше — количественное подтверждение этой петли.
Кто это делает
Внешний контур — на стыке SEO и PR, и в этом организационная сложность. SEO-специалист умеет анализировать источники и работать с данными, но не умеет договариваться с редакциями. PR-менеджер умеет размещаться, но выбирает площадки по медиакиту, а не по цитируемости. В GEO это должна быть одна команда с общей метрикой — иначе бюджет расходится по двум отчётам, которые не сходятся между собой.
Почему одно без другого не работает
Из всего сказанного легко сделать опасный вывод: раз главное снаружи, SEO-бюджет можно резать до нуля. Это ошибка, и дорогая.
Внешние упоминания приводят модель на сайт. Если краулер не получил доступ, если страница не отвечает на вопрос, если на ней нет ни одной конкретной цифры — извлекать нечего, и бюджет на внешние размещения сгорает. Вы оплатили разговор о себе, но не смогли его подтвердить.
И наоборот. Идеально вылизанный сайт без внешних упоминаний модель не встретит в источниках: нечему попасть в выборку документов, из которых собирается ответ.
Внутренний контур без внешнего — это магазин в переулке без вывески. Внешний без внутреннего — вывеска без магазина.
Метрики: почему старый отчёт больше не подходит
Если в отчёте только позиции и трафик — он не описывает происходящее. Вот что должно прийти им на смену.
Share of Voice — доля промптов из выборки, где бренд упомянут. Это замена позиций: единственная корректная форма ответа на вопрос «насколько мы видимы».
Citation rate по источникам — какие домены модель цитирует в вашей нише. Не только ваш сайт, но и все остальные: именно этот список превращается в план работ по внешнему контуру.
Тональность упоминаний — как именно модель вас характеризует, когда называет.
Доля конкурентов — кого называют вместо вас и с какой частотой.
Брендовый спрос — отложенный, но самый честный индикатор здоровья кампании.
Доступность для ИИ-ботов — технический контроль по логам сервера: кто из агентов и как часто забирает ваши страницы.
Методика замера. Выборка из 100−300 промптов, сгруппированных по стадиям воронки — от информационных до прямых сравнительных. Прогон 3−5 раз с усреднением: при разбросе выдачи 1/100 единичный замер не значит ничего. Фиксация не только упоминания, но и источников ответа.
Академическая основа подхода к измерениям — работа «Generative Engine Optimization at Scale: Measuring Brand Visibility Across AI Search Engines».
Инструменты: Ahrefs Brand Radar (на нём построены исследования выше), Semrush Enterprise AIO, LLM Pulse. Ни один не закрывает задачу целиком — часть выборки всё равно проверяется вручную.
Чек-лист: где у вас дыра — внутри или снаружи
Внутренний контур
Внешний контур
Три «нет» и больше в любом блоке — там и находится дыра.
- Вы проверяли, открыт ли сайт для GPTBot и PerplexityBot и др.?
- На ключевых страницах есть конкретика — цены, условия, сроки, характеристики?
- Дата последнего обновления основных материалов — в пределах года?
- У экспертных материалов есть указанные авторы с подтверждённой экспертизой?
- Первый абзац раздела отвечает на вопрос заголовка прямо, без разгона?
Внешний контур
- Вы знаете 10 источников, которые ИИ цитирует в вашей нише?
- Вы проверяли, что модель отвечает на прямой вопрос о выборе в вашей категории?
- Название компании написано одинаково во всех упоминаниях?
- Вы знаете, в какой тональности о вас говорит нейросеть?
- В отчёте подрядчика есть хоть одна метрика, не связанная с позициями и трафиком?
Три «нет» и больше в любом блоке — там и находится дыра.
Что в итоге
SEO не умерло. Оно просто никогда не отвечало за внешний контур — и раньше это было допустимо, потому что поисковик показывал ссылку на ваш сайт. Теперь нейросеть показывает ответ, собранный из чужих источников, и отсутствие во внешнем контуре означает отсутствие в ответе.
Умерла не дисциплина. Умер отчёт по SEO в его привычном виде — тот, где есть позиции и трафик, и больше ничего.
Умерла не дисциплина. Умер отчёт по SEO в его привычном виде — тот, где есть позиции и трафик, и больше ничего.
Смотрите также
Как нейросети перекраивают воронку продаж: от первого вопроса до повторной записи
Доверять ли алгоритмам полностью: можно ли вести Яндекс Директ через нейросеть без специалиста в 2026
Реклама в YouTube и Telegram в 2026 году: что запрещено, кому грозит штраф и что делать бизнесу
От SEO к GEO и AIO: как попасть в рекомендации ИИ-поисковиков